五个作业,从分词器到 RL
全部课业就是 A1–A5,每个配讲义 PDF、代码仓库和测试;每人 6 个 late day,单个作业最多用 3 个。
Building a Transformer LM
版本 26.0.3 · 47 页 · 15 个代码模块全部手写
要实现的:BPE tokenizer(训练 + 编解码)→ Transformer LM(Linear / Embedding / RMSNorm / SwiGLU / RoPE / softmax / scaled dot-product attention / MHA / block / 整模型)→ cross-entropy、SGD、AdamW、cosine + warmup、gradient clipping → 训练循环 + checkpoint → 解码生成。
要跑的:TinyStories 上训 BPE → 编码数据集 → 训小 Transformer → 采样 + 困惑度;再用 OpenWebText 训一版提交 leaderboard。
约束:不许用 torch.nn / torch.nn.functional / torch.optim 里的现成定义(只允许 Parameter、容器类 Module/ModuleList/Sequential、Optimizer 基类),其余 PyTorch 随便用。
| 部分 | Problems(分值) |
|---|---|
| 2 BPE Tokenizer | unicode1 (1)、unicode2 (3)、train_bpe (15)、train_bpe_tinystories (2)、train_bpe_expts_owt (2)、tokenizer (15)、tokenizer_experiments (4) |
| 3 Transformer 架构 | linear (1)、embedding (1)、rmsnorm (1)、positionwise_feedforward (2)、rope (2)、softmax (1)、scaled_dot_product_attention (5)、multihead_self_attention (5)、transformer_block (3)、transformer_lm (3)、transformer_accounting (5) |
| 4 训练目标与优化器 | cross_entropy (1)、learning_rate_tuning (1)、adamw (2)、adamw_accounting (2)、learning_rate_schedule、gradient_clipping (1) |
| 5 训练循环 | data_loading (2)、checkpointing (1)、training_together (4) |
| 6 生成 | decoding (3) |
| 7 实验 | experiment_log (3)、learning_rate (3)、batch_size_experiment (1)、generate (1)、layer_norm_ablation (1)、pre_norm_ablation (1)、no_pos_emb (1)、swiglu_ablation (1)、main_experiment (2)、leaderboard (6) |
数据集:TinyStories、OpenWebText(单文件纯文本)。
Systems and Parallelism
版本 26.1.3 · 48 页 · 基于 A1 的模型做性能工程
要实现的:benchmarking/profiling harness → activation checkpointing → Triton 版 FlashAttention-2(forward 必做,backward 可选)→ 朴素 DDP → flat-gradient DDP → 逐参数与通信 overlap 的 DDP → optimizer state sharding → FSDP → 各种并行策略的通信量/内存推导。
| 部分 | Problems(分值) |
|---|---|
| 2 Profiling & Benchmarking | benchmarking_script (4)、nsys_profile (5)、mixed_precision_accumulation (1)、benchmarking_mixed_precision (2)、memory_profiling (4) |
| 3 单卡内存 | gradient_checkpointing (4) |
| 4 GPU Kernels | pytorch_attention (2)、torch_compile (2)、flash_forward (15)、flash_backward (5)、flash_benchmarking (5) |
| 5 DDP | distributed_communication_single_node、naive_ddp (5)、naive_ddp_benchmarking (3)、minimal_ddp_flat_benchmarking、ddp_overlap_individual_parameters、ddp_overlap_individual_parameters_benchmarking |
| 6–7 显存优化 | optimizer_state_sharding (15)、optimizer_state_sharding_accounting (5)、fsdp (15)、fsdp_accounting (5) |
| 8 并行分析 | alternate_ring_all_reduce (1)、data_parallel_calcs (3)、fsdp_calcs (3)、tp_calcs (4)、fsdp_tp_calcs (6) |
| 9 Leaderboard | leaderboard:最快训练 step (10) |
环境:repo 里自带 A1 staff solution(cs336-basics/),也可以把 pyproject.toml 指向自己的实现;多卡实验需要 GPU。
Scaling Laws
版本 26.0.5 · 8 页 · 写代码少,重在实验设计与拟合
要实现的:用 Chinchilla 的 IsoFLOPs 方法,从 data/isoflops_curves.json 的合成训练结果拟合 N_opt ∝ C^a、D_opt ∝ C^b,外推到 1e23 / 1e24 FLOPs;再用官方 training API(跑在 B200 上)在 12 B200-hours 预算内自行设计 runs,拟合 scaling law,预测 48 B200-hours 下的最优模型尺寸、超参和验证损失。
| 部分 | Problems(分值) |
|---|---|
| 2 Scaling Laws Review | chinchilla_isoflops (5):两张外推图 + 预测的 N_opt / D_opt |
| 3 Constructing Scaling Laws | scaling_laws:leaderboard (50),按预测模型的真实表现评分 |
API:http://hyperturing.stanford.edu:8000,X-API-Key 用 8 位 Stanford ID,需在 Stanford 网络(或 VPN)。预算是硬上限,超了就拒绝请求;排队/运行按 max_runtime_seconds 预留、结束后按实际耗时结算。提交 writeup.pdf + code.zip,并把预测的最优超参和 loss 提交给 API。
Filtering Language Modeling Data
版本 26.0.1 · 16 页 · 从原始网页到可训练语料
要实现的:Common Crawl WARC/WET → HTML 转文本 → 语言识别 → PII 脱敏(邮箱/电话/IP)→ 有害内容过滤 → Gopher quality rules → 质量分类器 → exact line 去重 → MinHash + LSH 文档级去重 → 用过滤后的数据训模型对比效果。
| 部分 | Problems(分值) |
|---|---|
| 2 过滤 Common Crawl | look_at_cc (4)、extract_text (3)、language_identification (6)、mask_pii (3)、harmful_content (6)、gopher_quality_filters (3)、quality_classifier (15) |
| 3 去重 | exact_deduplication (3)、minhash_deduplication (8) |
| 4 过滤后训练 | filter_data (6)、inspect_filtered_data (4)、tokenize_data (2)、train_model (8) |
repo 自带 A1 模型的优化版训练脚本(支持多卡 DDP);代码写在 cs336_data/,测试走 tests/adapters.py 的 hook。
Reasoning RL
版本 26.0.0 · 39 页 · 后训练:SFT + RL
要实现的:zero-shot / few-shot / chain-of-thought prompting → GRPO(on-policy 推导 + 实现:tokenization、response log-probs、reward、group normalization、policy gradient loss、microbatch 聚合、train step)→ RL 变体(RFT、Dr. GRPO、MaxRL)→ off-policy GRPO(importance reweighting、token-level ratio、clipping、GSPO)→ 自选 policy gradient estimator。
要跑的:OLMo-2-0425-1B 在 GSM8K 上的 prompting baseline → on-policy GRPO → 各变体对比 → off-policy 加速实验。
| 部分 | Problems(分值) |
|---|---|
| 3 Prompting | prompting_baselines (5)、baseline_calcs (5) |
| 4 GRPO | tokenize_prompt_and_output (1)、get_response_log_probs (1)、compute_rollout_rewards (1)、compute_group_normalized_rewards_grpo (1)、compute_policy_gradient_loss_on_policy (1)、aggregate_loss_across_microbatch_sequence、grpo_train_step_standard_on_policy (5)、grpo_experiments (3)、grpo_learning_rate (3)、grpo_prompt_ablation (3) |
| 5 RL 变体 | think_about_length_normalization (1)、Dr.GRPO (0.5 + 0.5)、think_about_rft (2)、derive_difficulty_reweightings、think_about_advantage_normalization (2)、MaxRL (0.5)、grpo_train_step_variants (2.5)、grpo_experiments_variants |
| 6 Off-policy | derive_surrogate_objectives、compute_policy_gradient_loss_off_policy、think_about_importance_reweighting (2)、GSPO loss、grpo_train_step_off_policy (2.5)、grpo_experiments_off_policy |
| 7 自选 | try_your_own (10) |
repo 提供 vllm_utils.py(vLLM server + 权重同步)、drgrpo_grader.py(数学题判分)、prompts/;测试 tests/test_grpo.py,另有可选的 safety/DPO supplement。
Stanford CS336 · Language Modeling from Scratch · 官网没有单独的 lab section,全部课业就是 5 个 Assignment(A1–A5),每个都配讲义 PDF + 代码仓库 + 测试。
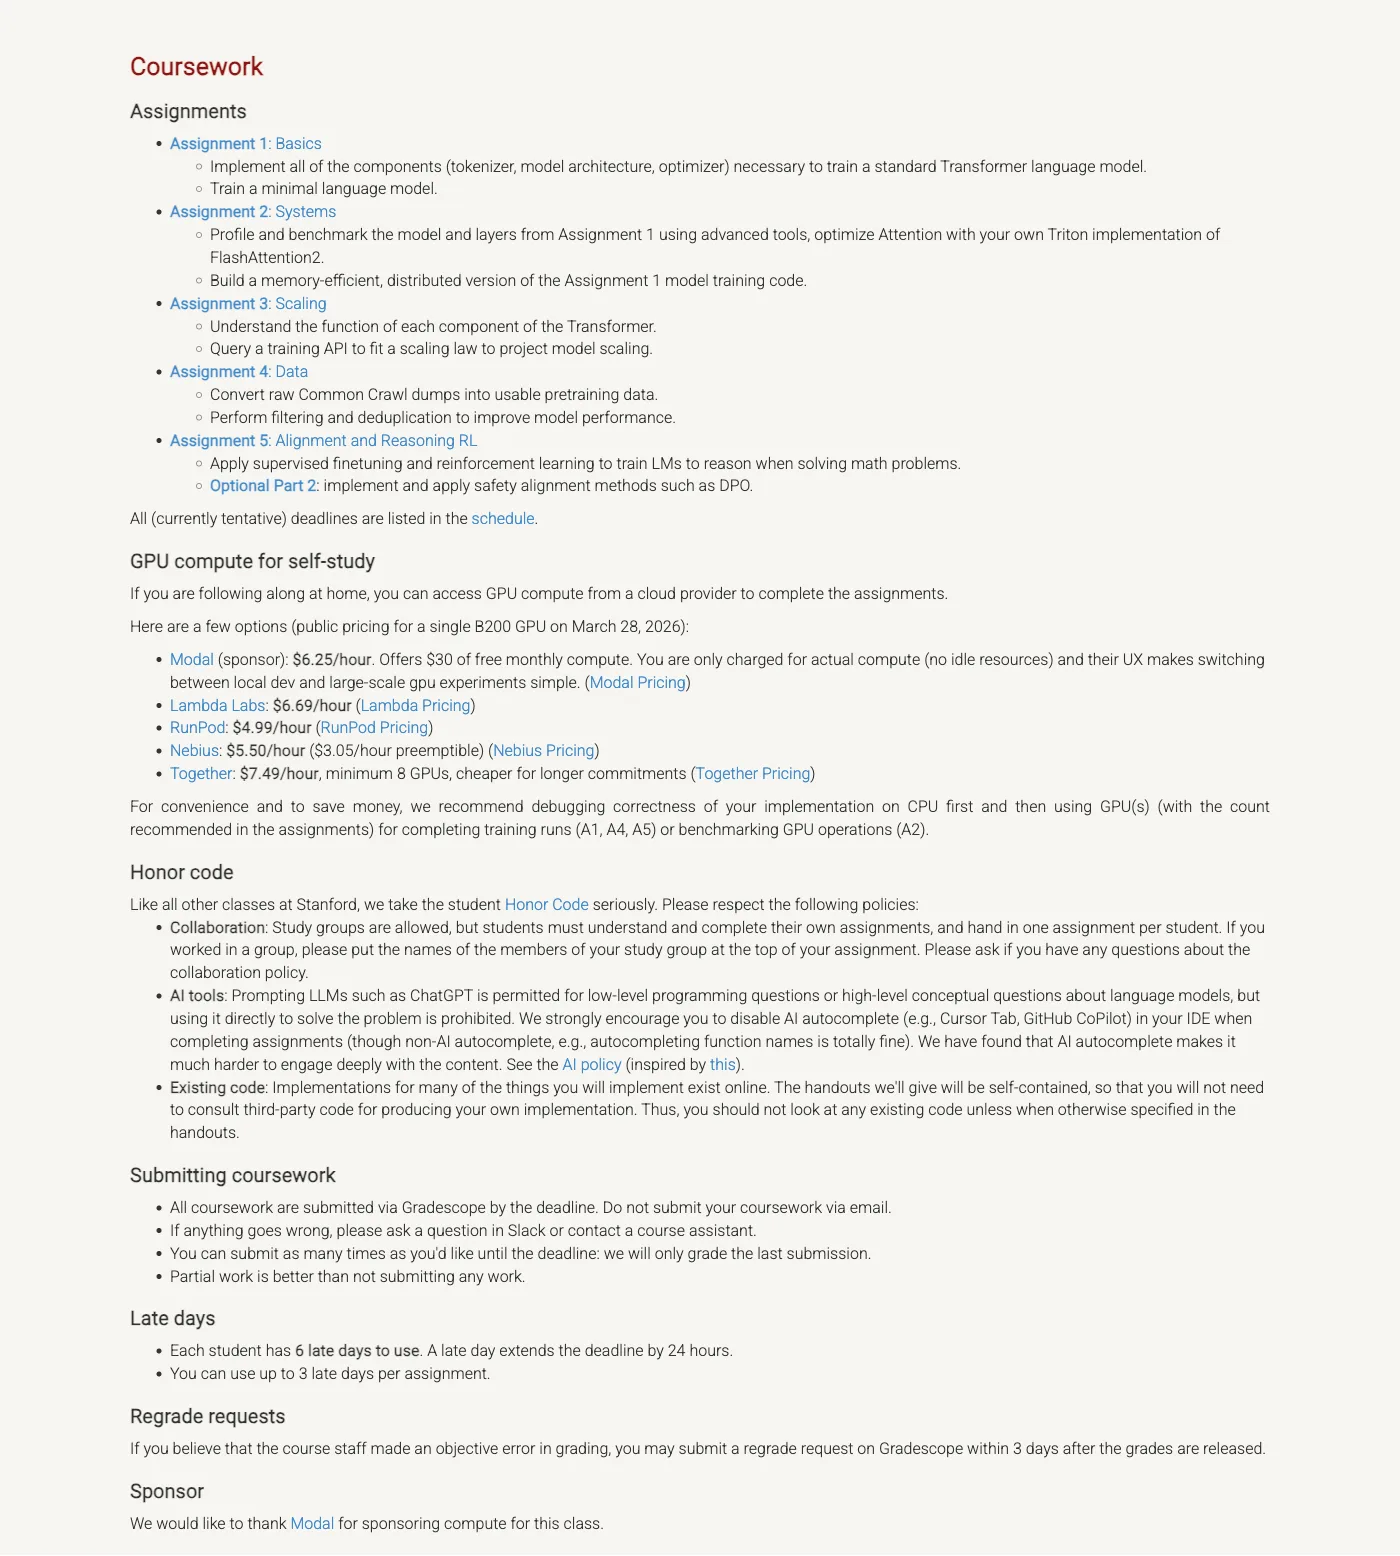
官方安排
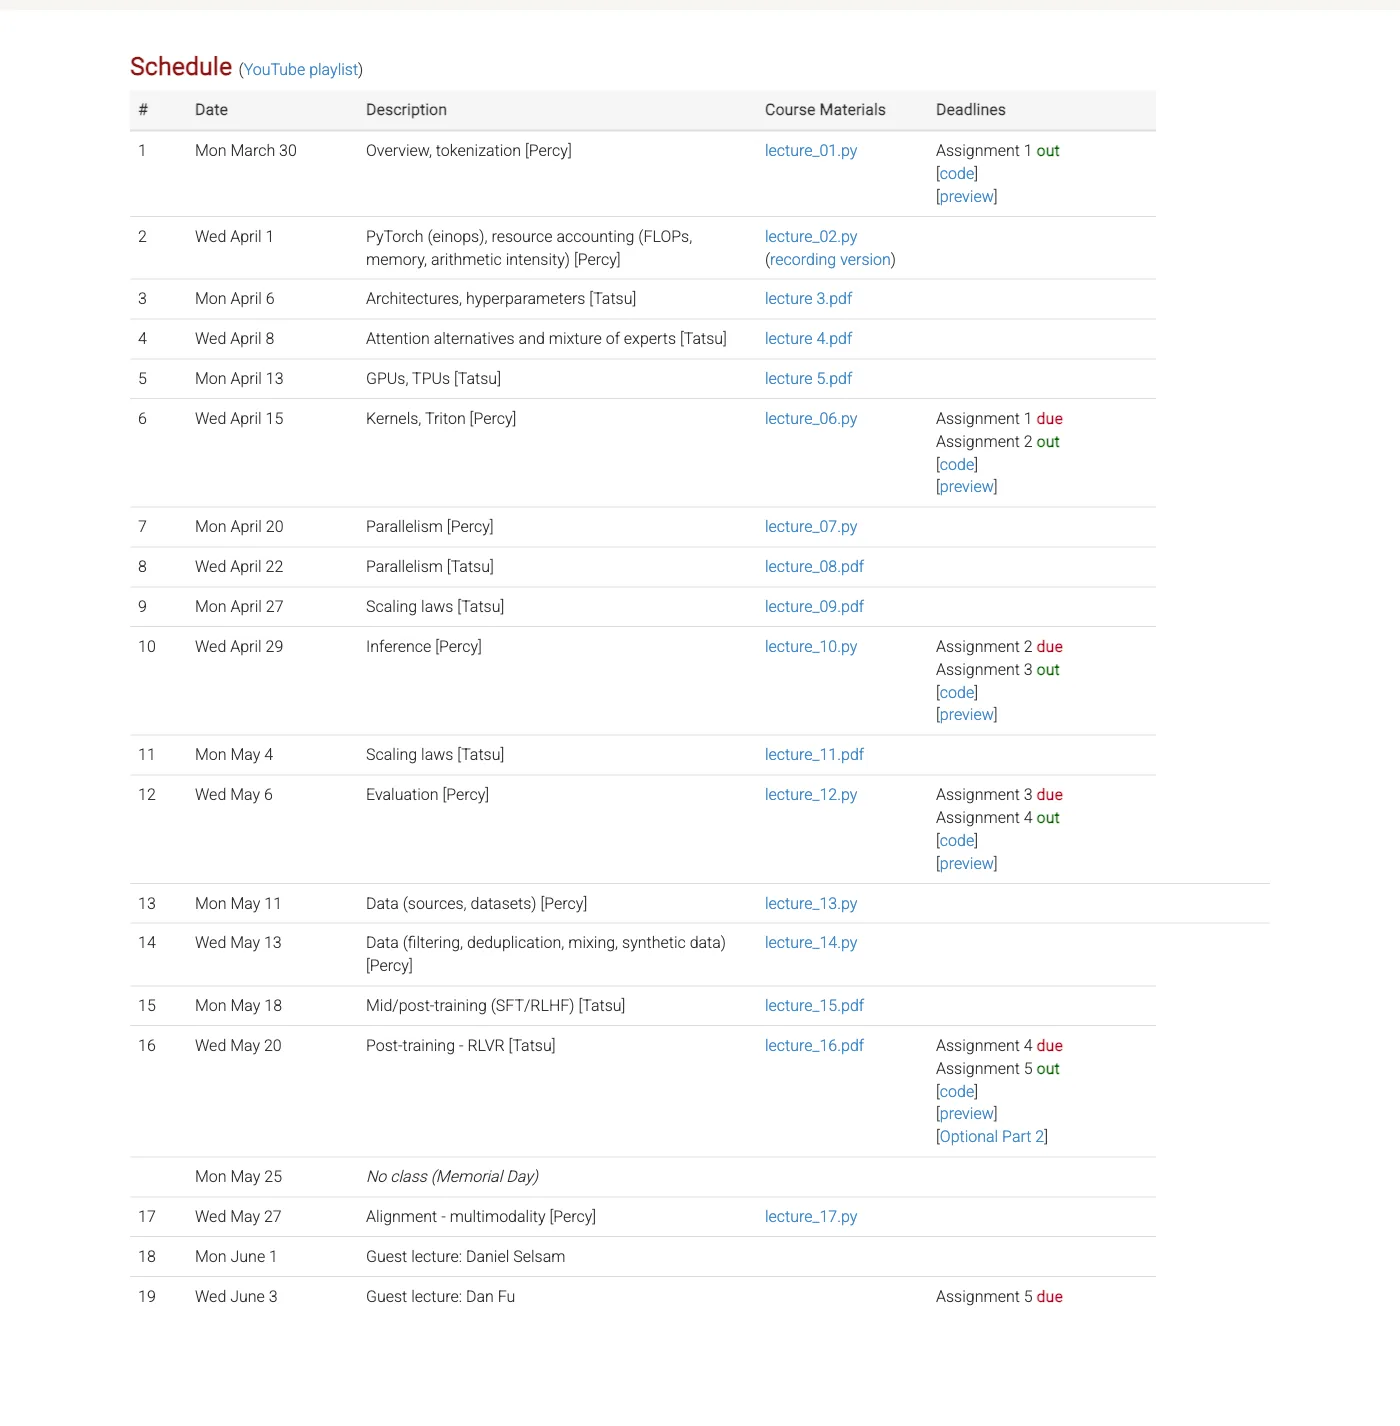
| # | 发布 | 截止 | 主题 | 对应讲座 |
|---|---|---|---|---|
| A1 | Mon Mar 30 | Wed Apr 15 | Basics:BPE 分词器、Transformer、优化器、训练循环 | L1–L2 |
| A2 | Wed Apr 15 | Wed Apr 29 | Systems:profiling、FlashAttention-2 Triton kernel、DDP/FSDP | L5–L8 |
| A3 | Wed Apr 29 | Wed May 6 | Scaling:IsoFLOPs 拟合 scaling law,用训练 API 预测最优模型 | L9、L11 |
| A4 | Wed May 6 | Wed May 20 | Data:Common Crawl → 文本、过滤、去重、训模型验证 | L13–L14 |
| A5 | Wed May 20 | Wed Jun 3 | Alignment:prompting、GRPO、RL 变体、off-policy | L15–L17 |
截止日期官网标注为 tentative;只有最后一次提交计分;每人 6 个 late day,单个作业最多用 3 个。
作业索引
讲义 PDF 已下载到本目录,可直接离线打开;代码仓库仍指向 GitHub。
| 作业 | 代码仓库 | 讲义 PDF(本地) |
|---|---|---|
| A1 Basics | assignment1-basics | assignment1-basics.pdf · 47 页 |
| A2 Systems | assignment2-systems | assignment2-systems.pdf · 48 页 |
| A3 Scaling | assignment3-scaling | assignment3-scaling.pdf · 8 页 |
| A4 Data | assignment4-data | assignment4-data.pdf · 16 页 |
| A5 Alignment | assignment5-alignment | assignment5-alignment.pdf · 39 页 |
A5 的选做 Part 2(safety alignment / DPO):assignment5-safety-rlhf-supplement.pdf · 18 页
所有作业统一交 Gradescope:writeup.pdf(书面题)+ code.zip(代码),A1/A2/A5 另用 make_submission.sh / test_and_make_submission.sh 打包;A1 和 A2 还有 leaderboard(A1 提交 PR 到 assignment1-basics-leaderboard;A2 比最快训练 step)。
关于 AI 工具
讲义明确写了:AI 可以用于回答高层概念问题、查 API 签名一类的文档,但不允许用来实现作业的任何部分(包括 coding agent 和 IDE 自动补全)。用 AI agent 时必须让它读取 repo 的 AGENTS.md;用 chatbot 时要带上讲义里给的 prompt。官方建议写作业时关掉 Cursor Tab / Copilot。