做 AI 评测,最难得的竟然是诚实
看完 CS336 Lecture 12: Evaluation 之后
最近听了好友 binarytree 兄台的推荐,摸到 YouTube 上开始看 Stanford 的 CS336(Language Modeling from Scratch)。
作为一个在传统应试教育里浸泡出来的中国学生,我原本对「大学课程」这件事是彻底祛魅的。在我的刻板印象里,绝大部分课程不过是师生之间心照不宣地演一场戏:老师照着几年前的 PPT 走马观花,学生划重点、背八股,考完试两不相欠;哪怕是名校公开课,无非也就是制作精良一点、课堂互动多一点罢了。
但看完 CS336,我发现对于这个星球上最顶尖的几门课,原有的评价体系彻底失效了。
带着工作问题
出于工作原因,我日常正好在做模型评测相关的事情。于是我决定先挑 Lecture 12: Evaluation 这一节入手,算是一次抽样——毕竟在自己天天踩坑的领域里,最容易一眼看出讲师到底是在念教材水课,还是真的花时间去准备这个课程。
看完 78 分钟,如果只用几个字来总结我的感受,那就是: 先进,先进,还是特么的先进。
先叠个甲:我并不是因为「听不懂、被不明觉厉的名词震住了」才夸它。恰恰相反,因为我自己就在一线做评测,这节课里讲到的具体方法——无论是 Perplexity、MMLU/GPQA 等刷榜题库,还是 Chatbot Arena、LLM-as-a-Judge、Agent 评测——并没有超出我现有的认知范围,听完也不会对我工作的时候的代码产生影响。
但正因为我看过太多垃圾论文,假大空的论文和教程,看着 Percy Liang 把那些垃圾中真正有点用处的内容,如此诚实、锋利、成体系地摊开在大学讲台上,才更觉得震撼。 它的先进,主要体现在下面这三个方面:
一、课程结构先进:不是拼凑章节,符合学生心智
国内很多教材和课程的目录是「按概念攒出来的」,各个章节各自为战,学完一学期也不知道怎么拼成一个能跑的系统。
但你看 CS336 的 Roadmap,完全是一线造模型的真实工程逻辑: 在 Lecture 12 之前,前 11 节课已经把模型架构、优化器、训练主循环、Kernel 与分布式并行加速、Scaling Laws 乃至推理加速全部讲透了——换句话说,走到这一步,你手里已经握着把一个模型从零训出来的全套工程能力了。
这时候,课程没有急着灌输花哨的技巧,而是立刻在 Lecture 12 抛出一个灵魂问题:「模型你是能训出来了,但你怎么知道它好不好?你到底想让它长成什么样?」 先用 Evaluation(评测)确立北极星指标(North Star---大家真的挺喜欢李飞飞的),再在下一周顺理成章地引出 Data——因为评测定义了「你想要什么行为」,而数据决定了「模型会训出什么行为」。对于真正想动手训点好玩模型的人来说,这种严丝合缝、环环相扣的 Roadmap,光是课程编排的逻辑就已经甩开那些体系混乱的课程几条街了。
二、信息时效先进:课件里居然有 Mythos,而同时,上个世纪的教材还在东方闪烁
看这节课的榜单截图时,我直接愣住了——讲义和演示切出去的排行榜上赫然躺着 Mythos(HLE 64.7%、SWE-bench Verified 93%)、GPT-5.5、Claude Opus 4.7、DeepSeek V4,甚至还有讲课前一个月才刚刚发布的 ARC-AGI-3。
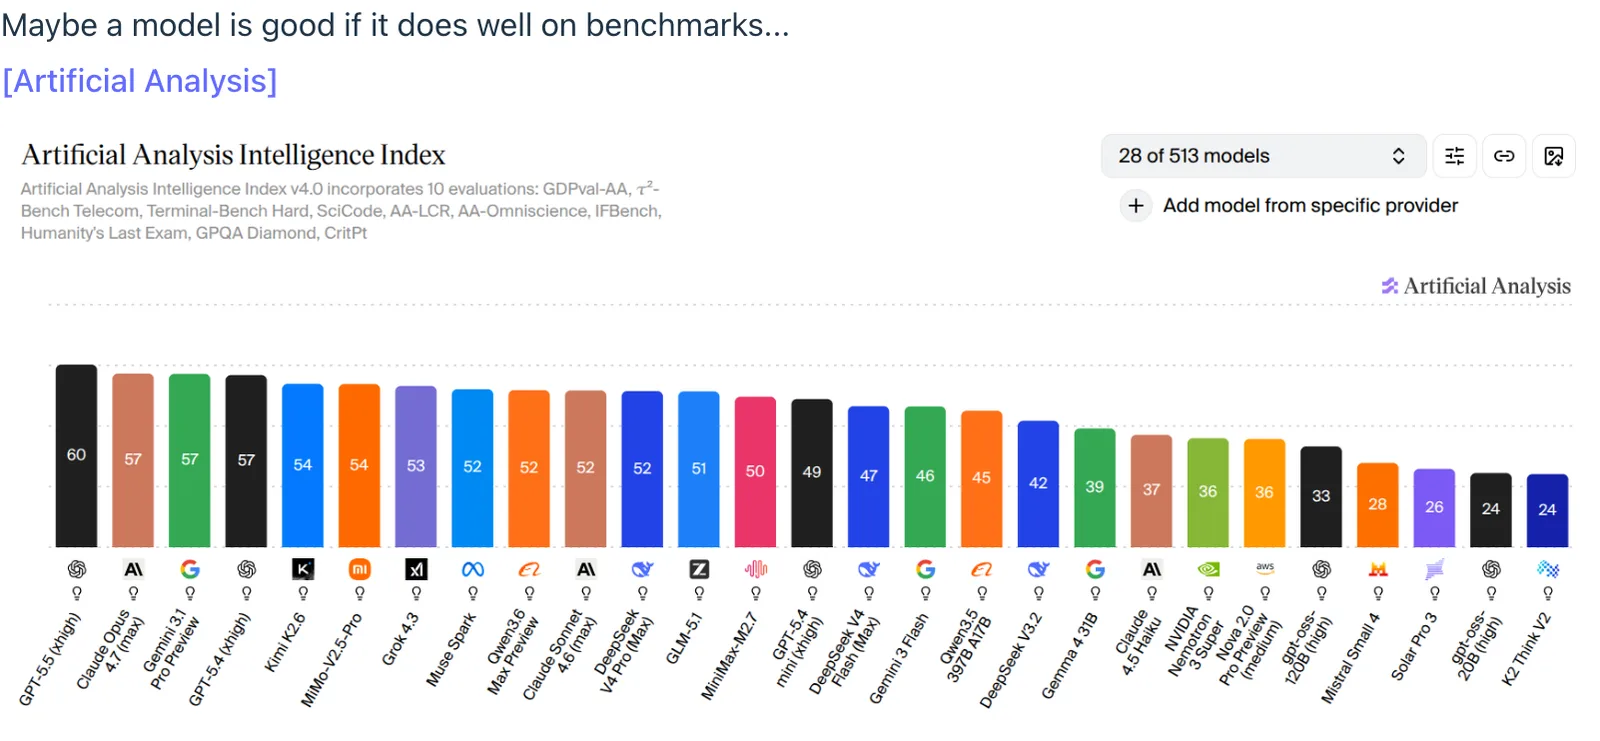
看到这一幕你大概就能明白,这门课的信息密度和时效性有多恐怖。我们见惯了太多「一套 PPT 传三代,截图包浆了都不换」的课堂;但在 CS336 里,教授是真的在每一学期、甚至每一周根据最新的业界进展重做课件。
他不是把最新的论文链接丢给学生了事,而是先用自己的能力去理解最新的数据和行业动态,消化整理之后再端上讲台。这不仅仅是「备课负责」四个字能概括的,更体现出讲台上的老师自己就时刻紧跟着时代和行业最前沿的发展。
三、底层思想先进:拒绝「八股标准答案」,坦然承认真实世界没有银弹
这是整节课最打动我的一点。
众所周知,传统的国内课程和教材极度依赖「唯一正确的标准答案」和「工整的八股句式」——A 的定义是什么,B 有哪三个优点,C 的标准解法是什么,仿佛只要背熟套路就能解决一切问题。
但真正做过评测的人心里都清楚:评测最头疼的地方,就在于处处都是妥协,根本没有完美解法。
而这门课给人的感觉,根本不像是在听老师照本宣科,更像是在听一位行业专家在会议上分享自己的见解和最佳实践。Percy Liang 在课上非常坦诚地把每一种主流评测方案的短板都摊开了讲:
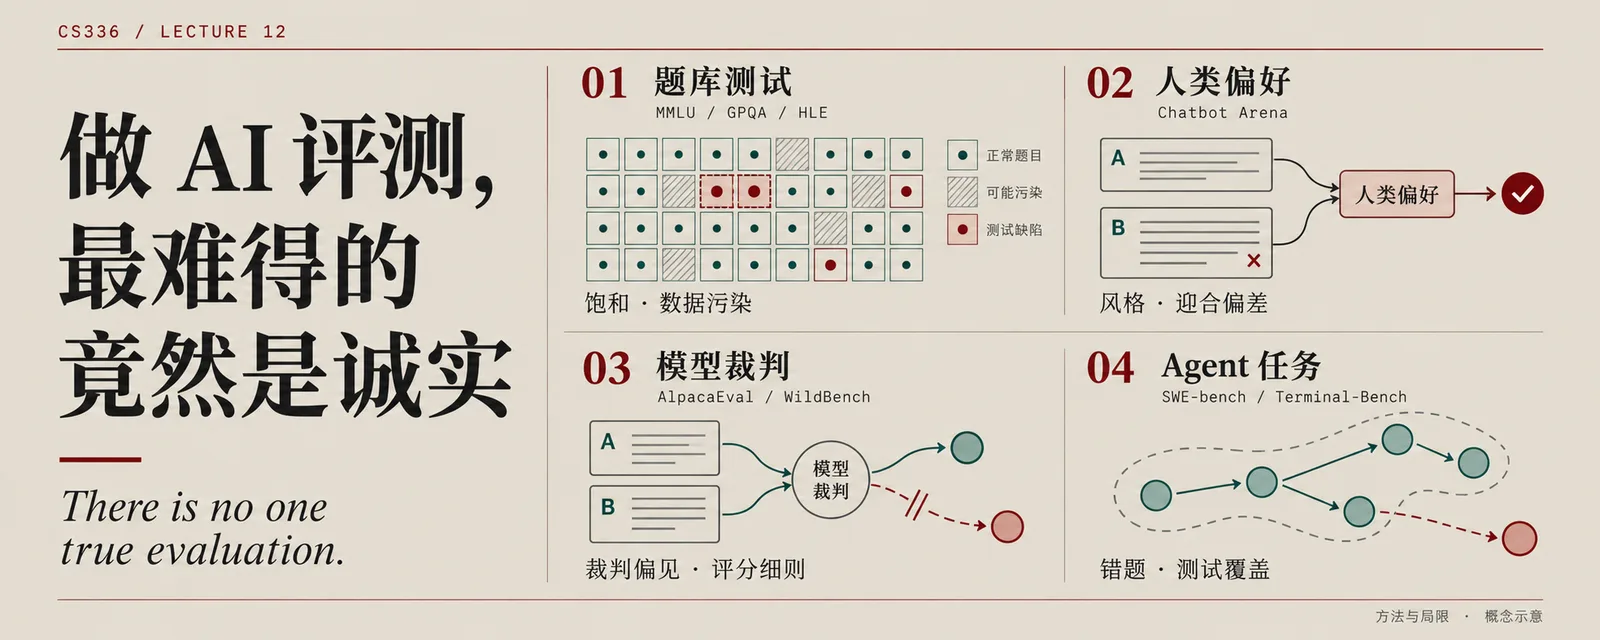
- 做考试选择题(MMLU / GPQA / HLE)? 答案唯一、好改卷,但不仅刷榜饱和极快,而且脱离真实场景——现实中谁会拿一道博士级四选一去跟 AI 聊天?
- 靠人类盲测打分(Chatbot Arena)? 贴近真实用户意图,但来白嫖算力的网民分布根本不可控,而且人类极易被长篇大论、排版好看、甚至「拍马屁(Sycophancy)」的回答迷惑,把风格讨喜当成事实正确。
- 用 LLM-as-a-Judge(AlpacaEval / WildBench)? 省下了人工成本,但裁判模型自己就带着偏见(比如天然给长回复打高分),如果不针对具体任务拆解 Rubric / Checklist(评分细则),连「什么是好」都是个伪命题。
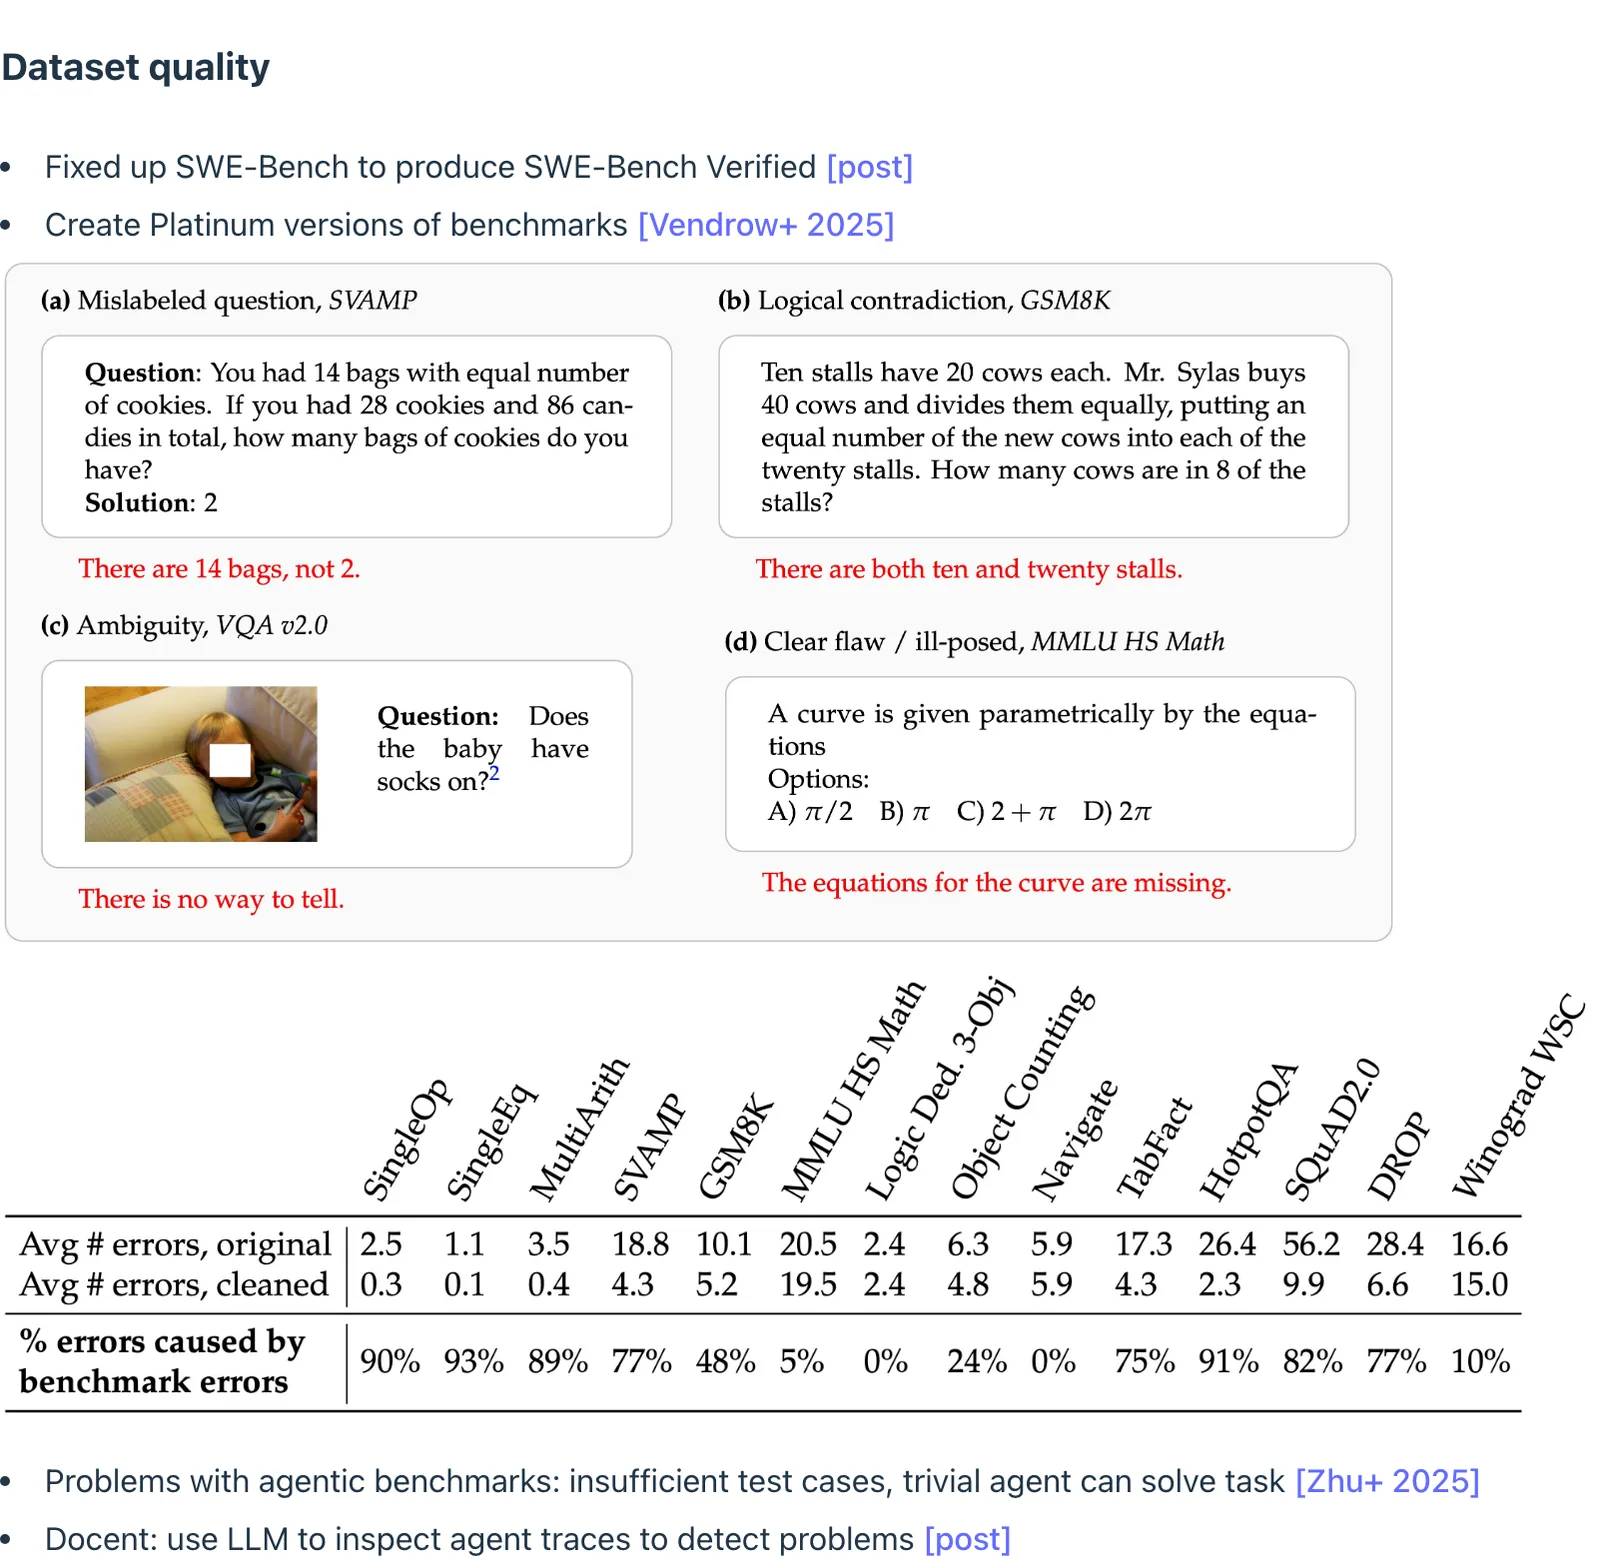
- 写 Script 跑单测测 Agent(SWE-bench / Terminal-Bench)? 看似最硬核客观,结果深扒数据集质量就会发现,很多经典题库本身就有错题,单测也经常覆盖不全,甚至有的 Agent Benchmark(如 Tau-bench)只要啥也不干输出空响应,就能白嫖 38% 的得分;更别提还有防不胜防的训练集污染(Contamination)和 Agent 脚手架(Scaffold)带来的干扰。
在这堂课里,你听不到什么故作高深的「通用标准解法」。相反,你会听到一位斯坦福教授大大方方地承认:「很多事情目前就是没有好的解法」「很难做出一个放之四海而皆准的通用 Benchmark(There is no one true evaluation)」。
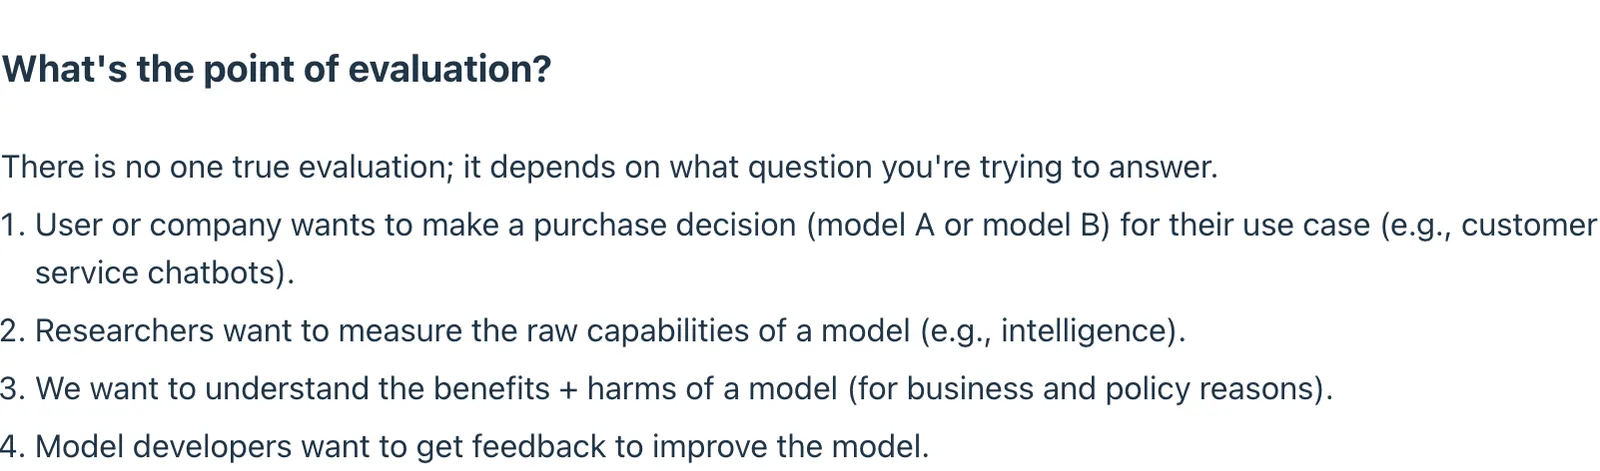
因为高难度、真实性(Ecological Validity)、抗数据污染、低成本可复现,在评测里本身就是互相打架的。做评测不是套公式算一个绝对客观的数字,而是先想清楚你的目的到底是什么,再决定你愿意在哪个维度上做妥协。
写在最后
回过头看,为什么一节「知识点并没有超出我个人认知」的课,还是让我觉得这么惊艳?
因为一般的课程总想把复杂的问题简化成「可以背诵的标准答案」,让你觉得背熟几个名词就学会了;而像 CS336 这样真正优秀的课恰恰相反——它把真实世界里的权衡、局限和还没有解决的问题诚实地摆在你面前,不喂你八股,而是带你用真正做工程、做研究的脑子去思考问题。